Dedykowany system OCR: jak w Otoro SI tworzymy, testujemy i dostrajamy go pod Twoje dokumenty

Gotowy OCR dobrze wypada na demo. Potem trafia na prawdziwe dokumenty firmy: zdjęcia z telefonu, stare skany, tabele i polskie znaki. Okazuje się, że silnik, który świetnie czyta jedną fakturę, myli się na kolejnym typie dokumentu. W Otoro SI nie sprzedajemy gotowego narzędzia. Tworzymy system OCR pod dokumenty konkretnej firmy, testujemy go na jej materiałach i, gdy to potrzebne, dostrajamy model do zakresu prac.
Dokumenty w firmie są różne, a od tego zależy, który silnik i jakie kontrole mają sens. Najczęściej różnią się pięcioma rzeczami:
Przykład z naszych testów: bazowy model OCR zachowywał tylko ok. 69% polskich liter, więc „łódź” wychodziła jako „lodz”. Dla człowieka to drobiazg, dla wyszukiwarki lub systemu księgowego to inne słowo. Szczegóły opisaliśmy w artykule o dostrajaniu modelu.
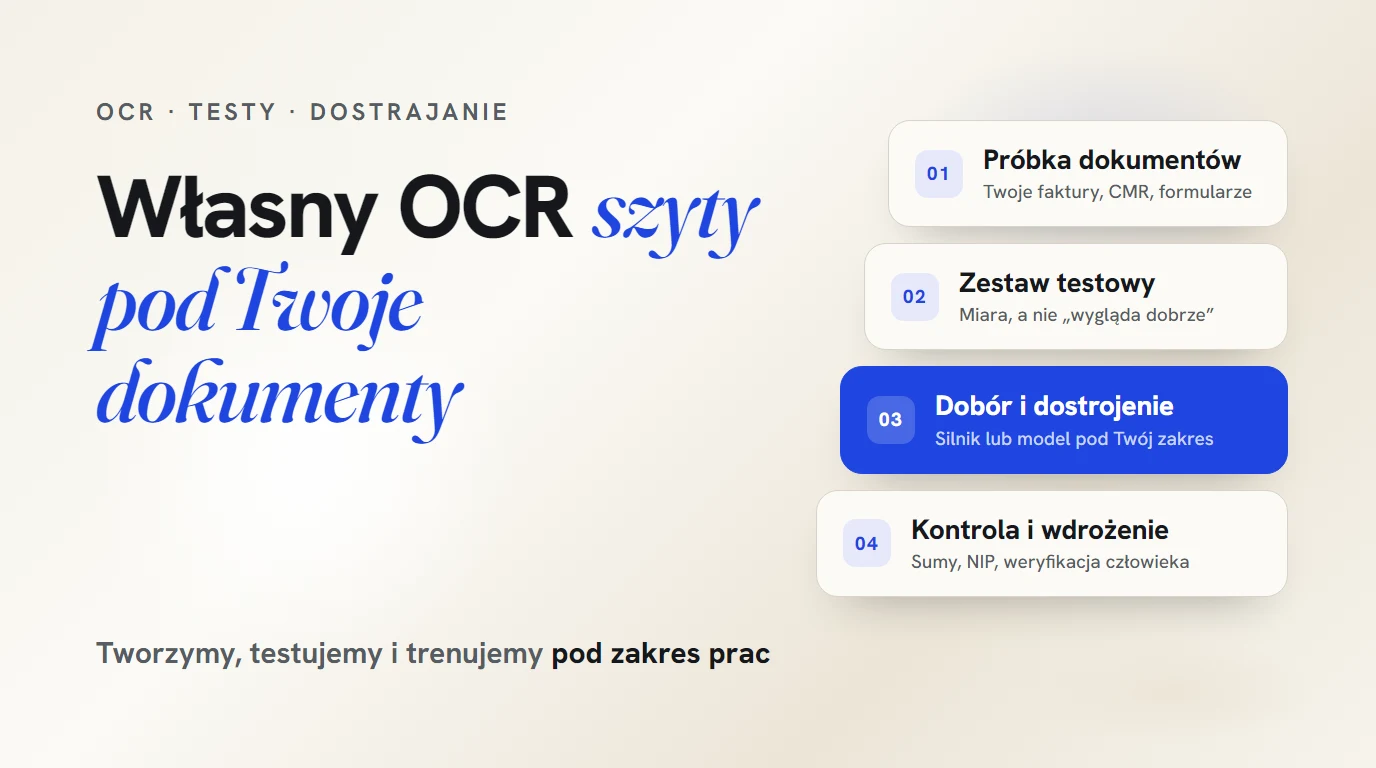
Pracujemy w sześciu krokach. Zaczynamy od rozmowy, a kończymy na wdrożeniu, a po drodze każdą decyzję opieramy na pomiarze.
Ustalamy, jakie dokumenty macie, ile ich jest i w jakim stanie przychodzą. Ustalamy też, które pola są potrzebne (np. kwota, NIP, numer dokumentu, pozycje, daty) i dokąd mają trafić dane. Czasem odradzamy OCR, jeśli wystarczy prostsze rozwiązanie.
Bierzemy próbkę dokumentów, z trudnymi przypadkami włącznie, i przygotowujemy zestaw testowy z poprawnymi odpowiedziami. Od tej chwili „działa” znaczy „osiąga wynik na tym zestawie”, a nie „wygląda dobrze na demo”.
Porównujemy klasyczne silniki (Tesseract, PP-OCR) z modelami wizyjnymi na tym samym zestawie. Z naszych testów wynika, że na czytelnym druku klasyczny silnik bywa co najmniej tak dobry, a przy tym szybszy i tańszy w utrzymaniu. Model wizyjny przydaje się jako drugi krok przy tabelach, zdjęciach i złożonym układzie. Często najlepszy jest układ hybrydowy, w którym rozbieżności między silnikami trafiają do ręcznej weryfikacji. Porównanie generacji OCR opisaliśmy w artykule Modele OCR w 2026.
Dostrajamy tylko wtedy, gdy pomiar pokazuje powtarzalny błąd, którego nie naprawi prompt ani RAG. Robimy to metodą LoRA: do modelu dokładamy niewielki adapter i uczymy tylko jego, zamiast trenować cały model. Dzięki temu da się to zrobić lokalnie i szybko, a zakres treningu dopasować do zakresu prac. W naszym własnym modelu użyliśmy do tego wyłącznie danych syntetycznych.
Sam odczyt to nie wszystko. Przed księgowaniem lub dalszym przetwarzaniem sprawdzamy sumy, NIP i numery rachunków. Tam, gdzie pewność odczytu jest niska albo wyniki silników się rozjeżdżają, dokument trafia do człowieka. Reguły kontroli ustalamy z klientem na początku projektu.
Łączymy system z tym, z czego firma korzysta: ERP, skrzynką e-mail lub folderem z dokumentami. Wdrożenie może działać lokalnie lub w prywatnej infrastrukturze, a kod i dokumentacja zostają u klienta.
Te same wskaźniki liczymy przed i po każdej zmianie (nowy typ dokumentu, inny silnik, dostrojony model), dzięki czemu wyniki można porównać. Najczęściej mierzymy:
Poniżej wynik, który zmierzyliśmy dla własnego modelu OCR dostrojonego do polskich znaków:
| Zbiór testowy | Model | Polskie litery zachowane | Błąd znakowy (CER) |
|---|---|---|---|
| 84 obrazy syntetyczne | bazowy | 68,9% | 2,63% |
| 84 obrazy syntetyczne | po dostrojeniu | 94,0% | 1,08% |
| 11 prawdziwych skanów | bazowy | 81,5% | 1,40% |
| 11 prawdziwych skanów | po dostrojeniu | 96,4% | 0,55% |
To mała próbka (11 wycinków z czterech dokumentów), więc liczby traktuj jako orientacyjne. Kierunek jest jednoznaczny. W projekcie dla klienta te same wskaźniki liczymy na jego dokumentach i dopiero one decydują o wyborze rozwiązania. Pełne wyniki i ograniczenia są w artykule o dostrajaniu, a sam model jest publiczny na Hugging Face.
System szyjemy pod dokumenty, które w firmie powtarzają się w dużej liczbie: faktury kosztowe i sprzedażowe, listy przewozowe CMR, protokoły, formularze oraz umowy w formie druku. Jednym ze scenariuszy jest obieg dokumentów obok KSeF, ale to samo podejście stosujemy do dokumentów, które z księgowością nie mają nic wspólnego. Szczegóły usługi znajdziesz na stronie OCR i obieg dokumentów.
Zaczynamy od krótkiej rozmowy o dokumentach i celu. Potem możesz zobaczyć prototyp na próbce własnych dokumentów, zwykle w 48 godzin od jej przekazania. Wycenę przedstawiamy po ocenie Twojej sytuacji i wymaganych integracji, przed startem prac.
Przekaż próbkę dokumentów, a pokażemy wynik na zestawie testowym, zanim zapadnie decyzja o wdrożeniu. Cena zależy od indywidualnej oceny dokumentów i wymaganych integracji.
Zapytaj o ofertę →Gotowe narzędzie jest ustawione pod przeciętny dokument. Dedykowany system dobieramy i testujemy na dokumentach konkretnej firmy, z kontrolami dopasowanymi do tego, ile kosztuje błąd w danym polu (np. kwota, NIP albo numer rachunku).
Dostrajamy model tylko wtedy, gdy pomiar pokazuje powtarzalny błąd, którego nie naprawi prompt ani RAG. W naszym własnym modelu użyliśmy wyłącznie danych syntetycznych, a prawdziwych skanów tylko do testów. Zasady wykorzystania dokumentów klienta ustalamy przed startem i zapisujemy je razem z umową o poufności.
Z pomiaru na zestawie testowym przygotowanym z dokumentów klienta. Kryterium sukcesu (np. poprawność kwoty i NIP oraz odsetek dokumentów kierowanych do człowieka) ustalamy przed budową, a nie po niej.
Nie muszą. Możemy wdrożyć system na Twoim serwerze lub w prywatnej infrastrukturze, na modelach lokalnych, bez wysyłania dokumentów do zewnętrznych dostawców. Współpracę zaczynamy od umowy o poufności.
Tego nie obiecujemy. Nasz model OCR jest dostrojony do druku, a przy rękopisach sprawdza się słabo, więc taki przypadek oceniamy indywidualnie na próbce Twoich dokumentów.
Cena zależy od indywidualnej oceny Twoich dokumentów (rodzaje, jakość, ilość) i wymaganych integracji, a wycenę przedstawiamy przed startem prac. Prototyp na próbce dokumentów można zobaczyć zwykle w 48 godzin od jej przekazania.
Jak dostroiliśmy lokalny model OCR do polskich znaków i jakie ma ograniczenia.
Czytaj artykuł →Które pokolenie OCR wybrać do faktur, skanów i pisma odręcznego.
Czytaj artykuł →